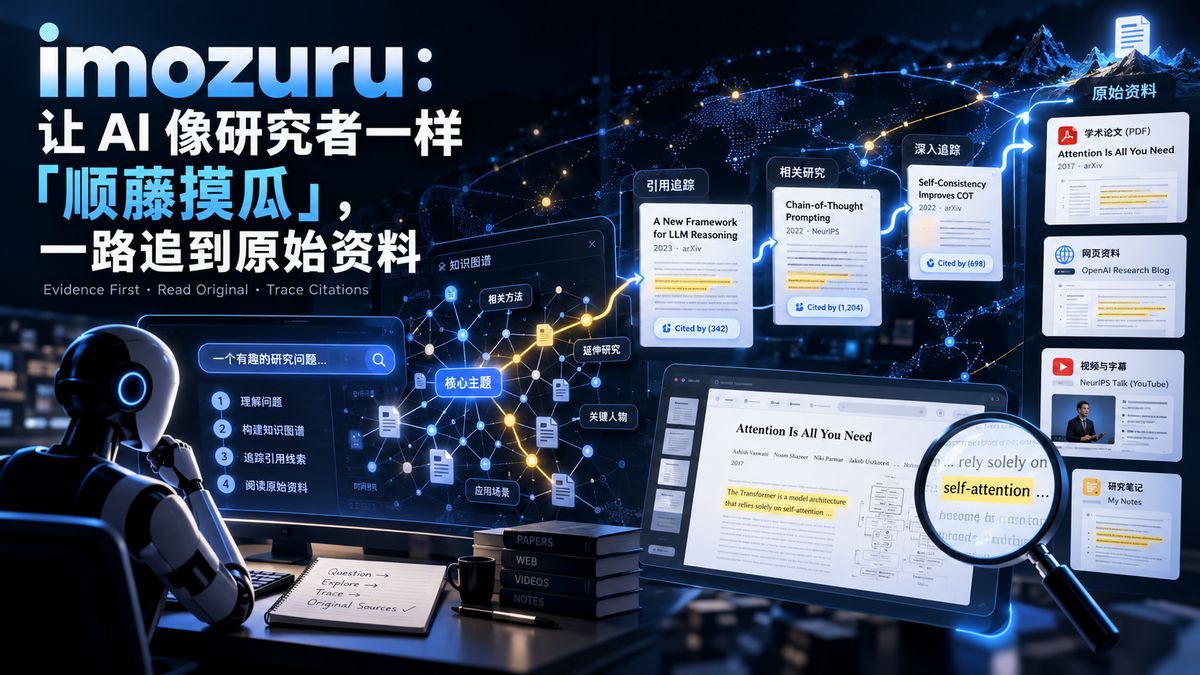
现在让 AI“帮我研究一下某个问题”已经非常容易。
无论 ChatGPT、Claude,还是各种 Deep Research Agent,通常都会执行类似流程:搜索网页 → 阅读若干结果 → 汇总信息 → 输出一篇带引用的答案。
这种方式最大的优点是快,但也存在AI 过早就开始总结的问题。
当你对一个领域本来就不了解时,你甚至不知道应该搜索什么关键词,也不知道这个领域真正重要的人是谁、经典资料是什么、哪些资料只是二手转述。
于是 AI 很容易围绕最初搜索出来的几个关键词不断扩展,最终生成一篇“看起来很完整”,实际上仍停留在二手资料层面的报告。
最近看到的开源项目 imozuru,尝试换一种完全不同的思路解决这个问题。
它不是急着帮你写研究报告,而是让 Claude Code 像真正做资料研究一样:先认识一个领域,再沿着引用、链接、作者和资料来源,一路“顺藤摸瓜”追到原始材料。
imozuru:https://github.com/MaryCache/imozuru
imozuru 是一个 Claude Code 技能(Skill),名字来自日语「芋づる式」,意思接近中文的「顺藤摸瓜」。它的思路是把信息检索研究里描述的人类找资料方式交给 AI 执行:先摸清一个领域的术语、核心人物和交流场所,再沿着引用、链接和作者一路追下去,最后把命中的原文原样落到本地。
imozuru 理论基础来自图书馆信息学的经典研究:Bates 的 berrypicking(边走边捡、问题会演化)、Ellis 的探索行为模型、Kuhlthau 的 Information Search Process 等。作者把这些方法论直接编码进了 Skill。
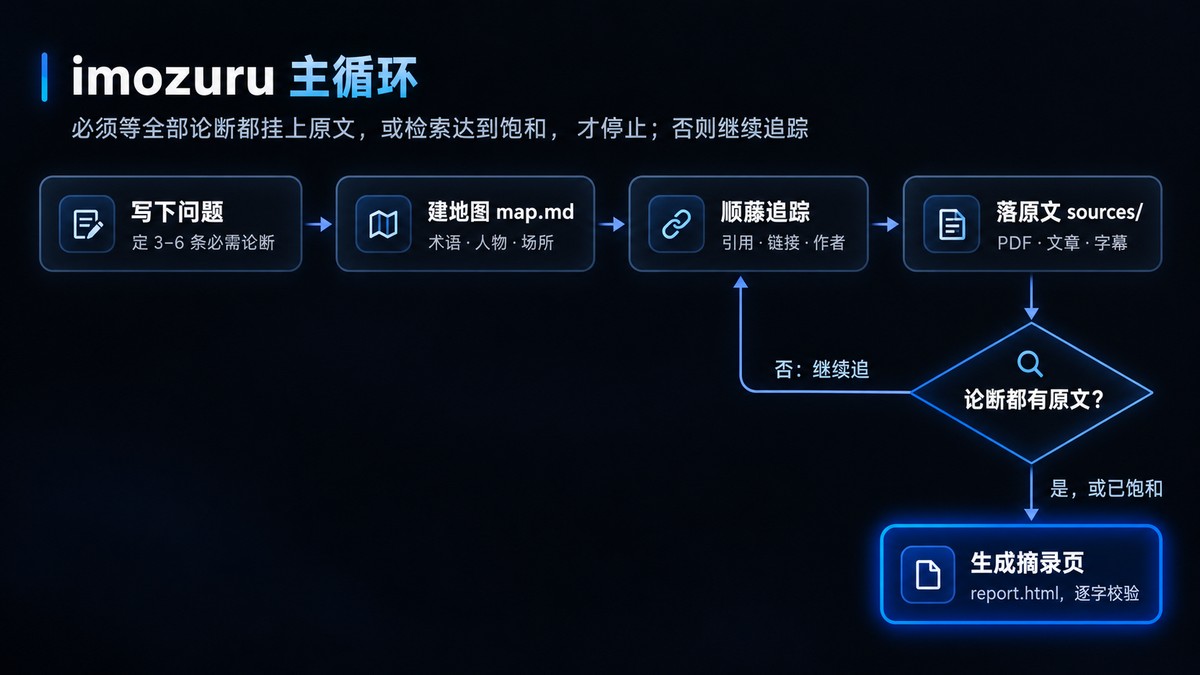
imozuru 的一次调研是一个循环:先定下回答问题必需的论断,建术语地图,沿引用追踪、下载原文,直到每条论断都挂上原文出处,或检索已经饱和,才生成摘录页。
除了这个主循环,imozuru 还有一个「监视」模式:对调研中发现的信息源(Qiita、Zenn 标签、note、YouTube、博客、arXiv)拉取 RSS 新内容,附上原文首行列出。
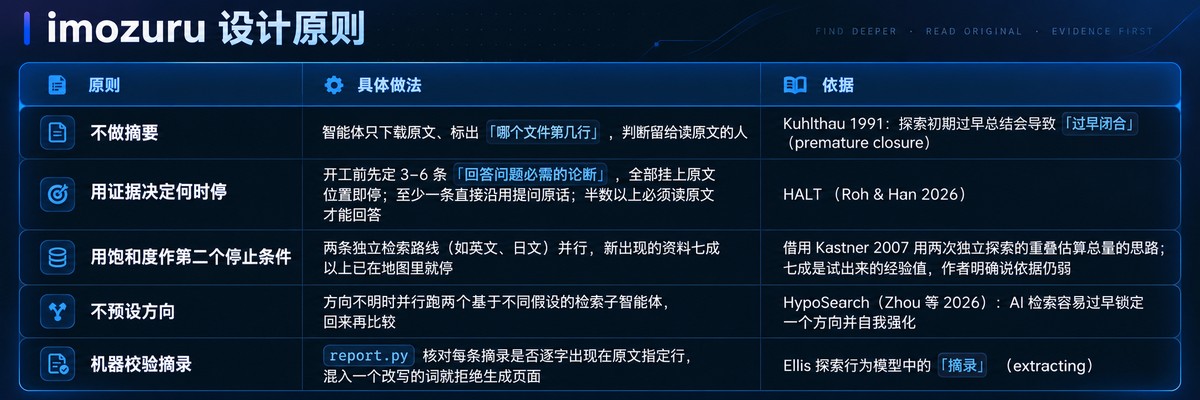
imozuru 的设计原则很值得做研究的借鉴。
imozuru 最适合什么场景?
imozuru 并不适合所有搜索任务。它真正擅长的是那些需要「追根溯源」的深度研究:进入一个完全陌生的领域、追溯某个观点的最早出处、梳理技术或产品的发展脉络,以及为深度文章收集一手资料。
尤其当你还不确定该搜什么关键词、哪些人物和资料最重要时,它的优势会特别明显——它会先建立领域地图,再沿着引用、链接和作者关系,持续向原始来源追踪。
与「搜几篇网页后直接总结」的普通 Deep Research 不同,imozuru 更强调证据的发现与可验证性。因此,它特别适合技术史梳理、学术研究、行业调查、人物研究以及开源生态追踪这类场景:你需要自己保留判断,而不是被 AI 过早给出的结论带偏。
在“一键总结(TL;DR)”大行其道的时代,imozuru 反其道而行之:它不把 AI 当作最终的“总结者”,而是将其视为一位不知疲倦的“图书管理员与引文考证员”。
如果你厌倦了 AI 那些看似工整却经不起推敲的宏篇概括,不妨在 Claude Code 中试一试 imozuru,让你的下一次调研真正做到“顺藤摸瓜,直达本源”。
类似 imozuru 值得推荐的深度研究类 AI 工具还有:
https://github.com/assafelovic/gpt-researcher
https://github.com/dzhng/deep-research
https://github.com/langchain-ai/local-deep-researcher
https://github.com/199-biotechnologies/claude-deep-research-skill
https://github.com/stanford-oval/storm